Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
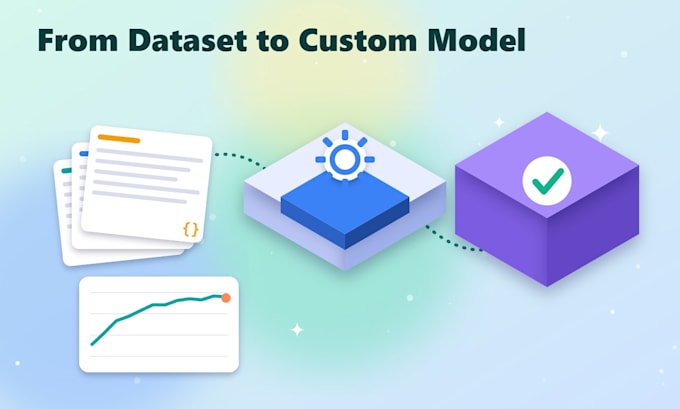
Wil je een open-source LLM dat echt jouw domein, formaat of stijl kent? Ik finetune het op jouw data en laat je zien, met cijfers, hoe veel beter het geworden is.
Ik ben een AI-onderzoeker (ICML 2026, IJCNLP-AACL 2025) en ik finetune en evalueer open modellen op multi-GPU H100 setups als onderdeel van mijn onderzoek.
Wat je krijgt:
Modellen: Llama, Qwen, Mistral, Gemma, DeepSeek en andere Hugging Face modellen.
Stuur me je dataset en doel voordat je bestelt, en ik stel het juiste basis model, methode en pakket voor.
AI Safety Researcher and LLM Fine Tuning Expert
Talen
Automatische vertaling
Automatische vertaling
Welk dataformaat heb je nodig?
JSONL, CSV of Parquet met instructie- en responsparen (of prompt en voltooiing). Als je data rauw of rommelig is, kan ik helpen deze eerst schoon te maken en te formatteren.
Heb ik mijn eigen GPUs nodig?
Nee. Ik kan trainen op cloud GPUs, met vooraf overeengekomen kosten, of trainen op jouw eigen cloud account of hardware als je data bij jou moet blijven.
Hoeveel data heb ik nodig?
Voor stijl- of formaatopdrachten kunnen een paar honderd goede voorbeelden genoeg zijn. Voor nieuwe domeinkennis of moeilijkere taken zijn een paar duizend beter. Als je minder hebt, help ik je een dataset op te bouwen of uit te breiden.
Word ik eigenaar van het fine-tuned model?
Ja. Je krijgt de adapter of samengevoegde gewichten, de training code en de configuratie. Jouw data en model blijven privé en worden niet hergebruikt door anderen. Gebruik is alleen onderhevig aan de licentie van het basis model.