Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Python scraping, data automatisering, Chinese sites specialist
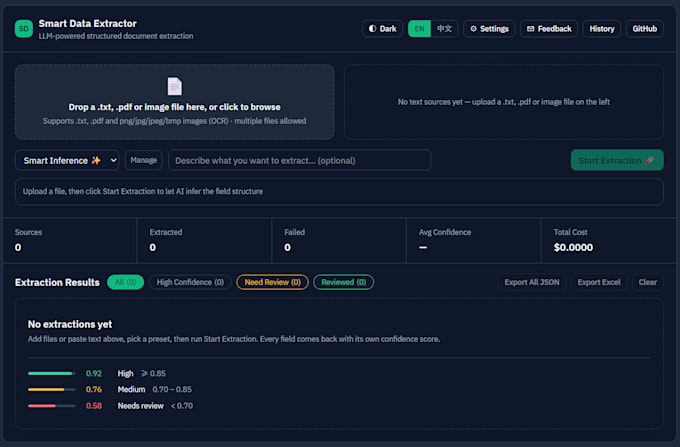
Heb je een tool nodig die PDF's, gescande documenten, afbeeldingen of geplakte tekst omzet in schone, gestructureerde data? Ik bouw maatwerk AI-gegevensextractiesoftware (Python, FastAPI, React) rondom jouw documenten en jouw velden.
WAT JE KRIJGT
- Een extractiepipeline met een LLM en OCR, opgebouwd volgens jouw schema (facturen, visitekaartjes, leads, formulieren of wat dan ook)
- Formaatvalidatie voor e-mail, telefoon, URL en datum-velden
- Een vertrouwen-score bij elk veld. Ontbrekende waarden blijven leeg en worden gemarkeerd, nooit verzonnen
- JSON/Excel-export, geleverd als CLI, REST API of webapp afhankelijk van jouw pakket
- Broncode, geautomatiseerde tests en een README
WAAROM DEZE AANPAK
Veel LLM-extractiedemo's zien er goed uit totdat ze stilletjes een waarde verzinnen. Daar ontwerp ik tegen: validatie, confianza-signalen vanuit de OCR-engine en een beoordelingsscherm voor onzekere velden. Ik belooft geen 100% nauwkeurigheid, maar verkeerde of ontbrekende velden worden gemarkeerd in plaats van door te glippen.
Deze gig is gebaseerd op een werkend project van mij met meer dan 700 automatische tests. Engels- en Chinese documenten worden ondersteund.
VOORDAT JE BESTELT
Stuur me een bericht met 3-5 voorbeelddocumenten en de velden die je nodig hebt, zodat ik de scope en het juiste pakket kan bevestigen.
Technologie:
Python
Expertise:
API integratie
•
Data-extractie
•
Data validatie
