Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Wil je data ophalen van een API, schoonmaken en ergens opslaan zodat je er mee kunt werken? Ik bouw Python ETL-pipelines die precies dat doen, geen ballast, geen over-engineering, gewoon werkende code.
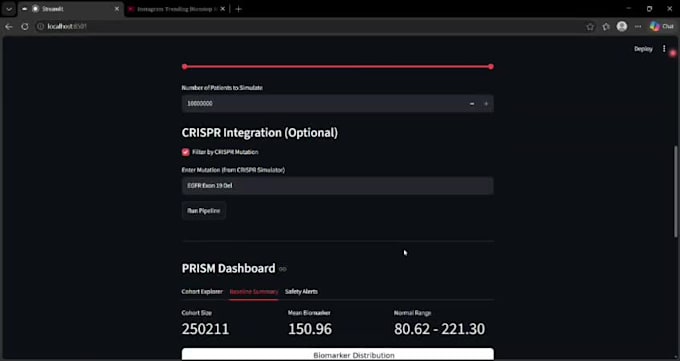
"Wat ik heb gebouwd: een klinische pipeline die echte trials ophaalde van ClinicalTrials.gov, 10.000.000 patiëntrecords filterde in minder dan 2 minuten op een gewone laptop, en elke run logde naar MySQL.
Portfolio: github.com/CodeXSourabhsingh
Mijn stack: Python, Pandas, NumPy, MySQL, Streamlit, Matplotlib, REST APIs.
Wat je krijgt:
- Werkende code, geen pseudocode
- Schone structuur, gedocumenteerd
- Werkt op elke standaard laptop
- 30 dagen bugfixes
Stuur me een korte briefing van 3 regels over welke data je hebt, wat je ermee wilt doen, welk output je nodig hebt. Ik reageer binnen 24 uur met een offerte en planning.
_msgphu.jpg)
_eujkga.jpg)
Technologie:
Python
•
Overige
Automatische vertaling
Bied je de data aan?
Nee. Jij levert de data bron (API, CSV, database). Ik bouw de pipeline die het verwerkt.
Kun je verbinden met elke API?
Ja, zolang het een gedocumenteerde endpoint heeft en geen complexe authenticatie. Als het OAuth of enterprise auth heeft, neem dan eerst contact op.
Hoe weet ik dat de pipeline werkt?
Ik stuur een werkende demo en een schermopname. Je kunt het testen voordat ik het definitief oplever.
Wat als ik na de bevalling wijzigingen wil aanbrengen?
Elk pakket bevat revisies. Na de limiet worden extra wijzigingen apart geoffreerd.
Wat maakt jouw werk anders dan dat van andere ontwikkelaars?
Ik heb 6 bio-data applicaties gedeployed in 17 dagen. Mijn klinische pipeline verwerkte 10 miljoen records in minder dan 2 minuten op een gewone laptop en werd publiekelijk gevalideerd door de CEO van een AI-native eClinical bedrijf. Ik werk met echte data van NCBI, ChEMBL en ClinicalTrials.gov - geen speelgoed.