Ik implementeer en stem een privé self-hosted llm af op jouw eigen GPU-server

S
stchopko
S
stchopko
Stepan C.
Sommige informatie is automatisch vertaald.

Over deze dienst

Automatische vertaling

Wil je een ChatGPT-achtige AI die draait op jouw eigen hardware, waarbij geen data naar derden gaat?

Ik zet het op en maak het snel.

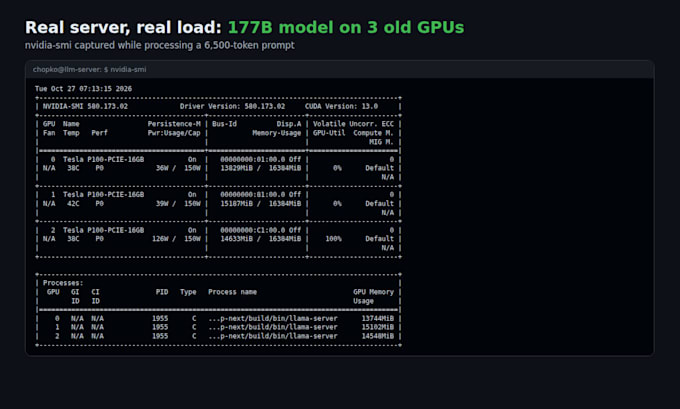
De meeste setups installeren slechts een runner met de standaardinstellingen en laten 2-3x minder prestaties zien. Ik benchmark en stem af voor jouw exacte GPU en RAM. Echte resultaten vanaf mijn eigen server (Tesla P100 16GB + EPYC):

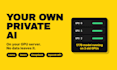
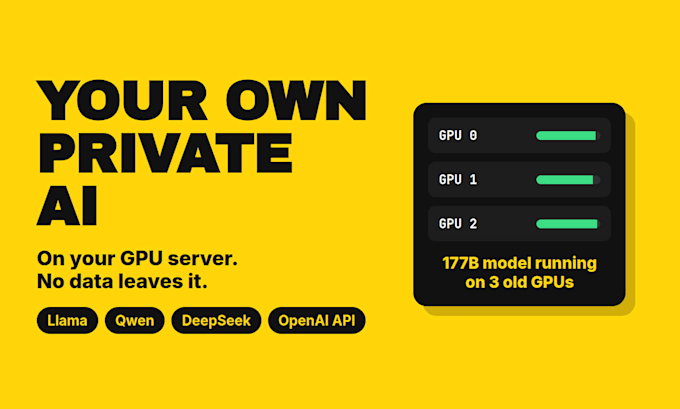
  • 177B-parameter MoE-model op drie oude 16GB-GPU’s met 13,5 tokens/s
  • 3,4x snellere promptverwerking (75 tot 254 tokens/s) door batchgroottes af te stemmen
  • 80B-coderingsmodel op 30 tokens/s op twee oudere GPU’s
  • De juiste quantisatie voor jouw generatie GPU

Wat je krijgt:

  • llama.cpp-server met een OpenAI-compatibele API
  • Web-chat interface
  • Modelkeuze voor jouw hardware en gebruikssituatie
  • Automatische startservice en beveiligde externe toegang
  • Benchmark-rapport: welke snelheid je krijgt en waarom

Stuur me jouw GPU, RAM en wat je wilt dat de AI doet, dan vertel ik je wat realistisch is voordat je bestelt.

Maak kennis met Stepan C.

Stepan C.

PHP Developer and Self Hosted LLM Engineer

  • Afkomstig uitOekraïne
  • Lid sindsmei 2021
  • Talen

    Oekraïens, Engels
Backend developer with 9 years of commercial PHP (Symfony, Laravel, legacy code), including 6 years as Senior PHP Developer at an Irish software company, and hands-on experience running large language models on my own hardware. I fix and upgrade PHP sites that broke after a PHP 8.x update, migrate projects to modern Linux servers, and deploy private, self-hosted LLMs that run on your own GPU - no data leaves your server. I don't guess: I find the root cause, fix it, and tell you what was wrong. Clear written communication, fast replies.

Automatische vertaling