Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Machine learning engineer
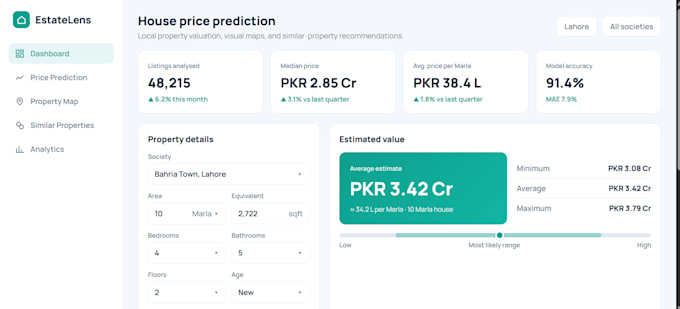
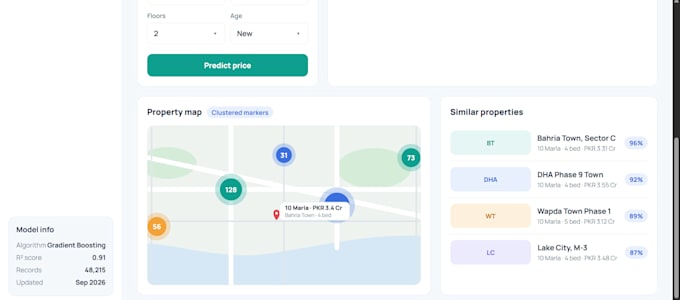
Heb je een machine learning model nodig dat op jouw data is getraind? Ik bouw, train, test en optimaliseer een aangepast ML-model dat nauwkeurige, betrouwbare voorspellingen geeft.
Ik ben een AI Engineer (PIAIC Gecertificeerd Generative AI Engineer) met ervaring in machine learning, deep learning, computer vision, NLP en spraakherkenning.
WAT IK KAN TRAINEN:
Classificatie & regressie (churn, prijs, fraude, vraag)
Beeldclassificatie & objectdetectie
NLP: sentiment & tekstclassificatie
Audio & spraakmodellen
Fijn afstemmen (PyTorch, TensorFlow, scikit-learn, Hugging Face)
WAT JE KRIJGT:
Data schoonmaak & preprocessing
Getraind model + volledige Python broncode
Evaluatierapport (nauwkeurigheid, F1, verwarringsmatrix)
Documentatie, API & cloud deployment (Premium)
WAAROM IK?
- Echte end-to-end projecten, geen tutorials
- Snelle reacties en duidelijke mijlpalen
- Eerlijke feedback over welke nauwkeurigheid jouw data kan bereiken
Stuur me een bericht voordat je bestelt met jouw datasettype en doel, en ik adviseer je over de beste aanpak!
Programmeertaal:
Python
•
MLflow
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-notitieboek
•
opencv
•
tensorflow
•
Excel
•
MLflow
Automatische vertaling
Q: Welke soorten ML-modellen kun je trainen?
Ik train classificatie, regressie, beeldclassificatie, objectdetectie, NLP, tijdreeks en audio/spraakmodellen met scikit-learn, PyTorch, TensorFlow en Hugging Face. Stuur me je use case en ik stel de beste aanpak voor.
Wat moet ik aanleveren voordat ik begin?
Jouw dataset (CSV, Excel, afbeeldingen, audio of tekst), een duidelijk doel (wat te voorspellen of classificeren) en eventuele nauwkeurigheidsdoelen of voorkeur voor framework. Gelabelde data is het beste, maar ik kan ook helpen als je data moet schoonmaken of labelen.
Kun je een specifieke nauwkeurigheid garanderen?
Geen enkele eerlijke engineer kan dat garanderen, omdat nauwkeurigheid afhangt van de kwaliteit en grootte van je data. Ik test meerdere benaderingen, optimaliseer het model en geef je een transparant evaluatierapport. Als je doel onrealistisch lijkt, vertel ik dat meteen.
Wat ontvang ik bij levering?
Het getrainde modelbestand (.pkl, .pt of .h5), volledige Python broncode en een evaluatierapport met metrics zoals nauwkeurigheid, F1 en verwarringsmatrix. Standaard en Premium omvatten ook tuning, documentatie en optionele deployment.
Zijn mijn gegevens veilig en vertrouwelijk?
Ja. Jouw data wordt alleen voor jouw project gebruikt en nooit gedeeld of hergebruikt. Ik ben bereid een NDA te ondertekenen op verzoek, en ik verwijder je data na het project als je dat vraagt.