Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Ingenieur machine learning
Heb je betrouwbare en schaalbare gegevenspijplijnen voor je bedrijf nodig?
Ik ontwikkel op maat gemaakte data engineering oplossingen om workflows te automatiseren, datakwaliteit te verbeteren en dataverwerking te stroomlijnen.
Mijn diensten omvatten:
Wat je krijgt:
Ik richt me op het bouwen van praktische oplossingen die aansluiten bij jouw wensen en bestaande infrastructuur.
Deel je datastromen, verwachte output, datavolume en voorkeurstechnologieën voordat je bestelt. Complexe projecten kunnen een op maat gemaakt aanbod vereisen.
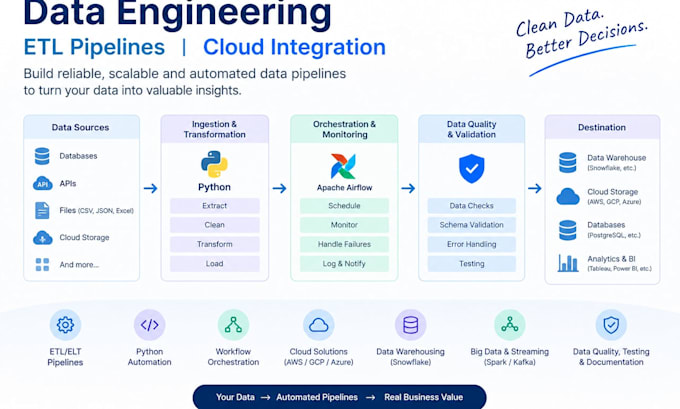
Tools & platforms:
Overige
Automatische vertaling
Welke informatie heb je nodig voordat je met een project begint?
Ik heb je projectvereisten nodig, datastromen, verwachte output, geschat datavolume, verwerkingsfrequentie en voorkeurstools of cloudplatform. Voorbeelden of geanonimiseerde data en bestaande code zijn handig indien van toepassing.
Welke technologieën en platforms ondersteund je?
Ik werk met Python, SQL, ETL/ELT workflows, Apache Airflow en soortgelijke orchestrators, Apache Spark, Kafka, Snowflake, Databricks en cloudplatforms zoals AWS, Google Cloud en Azure. De exacte technologie stack hangt af van de projectomvang.
Kun je werken met mijn bestaande data pipeline of codebase?
Ja. Ik kan helpen bij het oplossen van problemen, aanpassen, optimaliseren of uitbreiden van een bestaande pipeline. Deel de huidige architectuur, relevante code, foutdetails en gewenste resultaat zodat ik de scope kan beoordelen voordat ik begin.
Zijn cloud deployment inbegrepen in je pakketten?
Cloud deployment is alleen inbegrepen als dit expliciet is aangegeven in het gekozen pakket of als extra optie. Cloud gebruikskosten, abonnementen van derden en extra infrastructuurkosten zijn niet inbegrepen in mijn serviceprijs.
Kun je real-time data streaming pipelines bouwen?
Ja, voor duidelijk gedefinieerde use cases. Streaming integraties kunnen worden opgenomen in het toepasselijke pakket of als extra worden gekocht. Complexe Kafka clusters, systemen met hoge doorvoer en uitgebreide infrastructuursetup kunnen een op maat gemaakt aanbod vereisen.
Wat als mijn project meer werk vereist dan in het pakket is inbegrepen?
Ik beoordeel je wensen en verduidelijk de scope voordat ik begin. Als je project extra datastromen, complexe transformaties, extra integraties of infrastructuur nodig heeft buiten het gekozen pakket, kan ik een op maat gemaakt aanbod doen met een afgesproken prijs en opleveringsdatum.
