Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
AI-ingenieur, LLM, RAG en NLP-ontwikkelaar
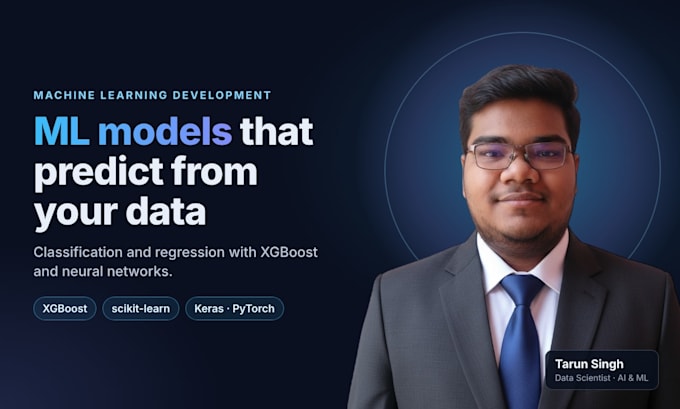
Heb je data in een spreadsheet of database en wil je betrouwbare voorspellingen eruit halen?
Ik bouw machine learning- en deep learning-modellen in Python die jouw tabelgegevens omzetten in nauwkeurige, uitlegbare voorspellingen.
Wat ik kan bouwen:
Wat je krijgt:
Waarom ik?
Ik ben een Data Scientist die dagelijks met ML en deep learning werkt. Ik bouwde een embedding-gebaseerd aanbevelingssysteem dat in productie draait, en een liedjes-aanbeveler voor meer dan 1.445 tracks. Ik leg de resultaten in begrijpelijk Engels uit, zonder jargon.
Stuur me je data en doelstelling voordat je besteld, en ik stel het juiste pakket voor.
Programmeertaal:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-notitieboek
•
tensorflow
•
Excel
•
MLflow
•
Colab
Automatische vertaling
Welke data heb je nodig?
Een CSV-, Excel- of SQL-export met de kolom die je wilt voorspellen. Een voorbeeld van 100+ rijen is genoeg om jouw project te bespreken.
Welke modellen gebruik je?
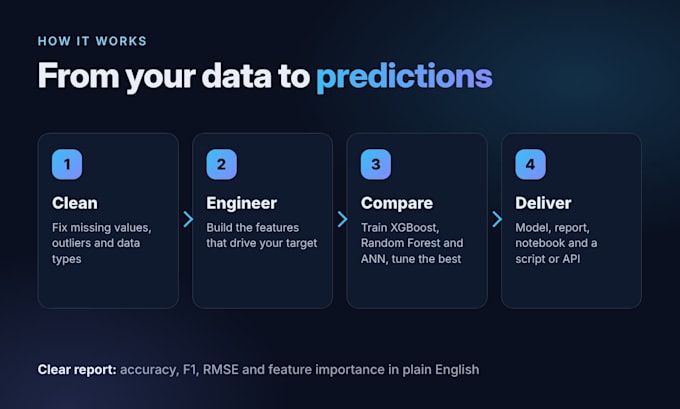
XGBoost, Random Forest, lineaire of logistieke regressie en neurale netwerken (ANN) met scikit-learn, Keras of PyTorch. Ik kies het eenvoudigste model dat aan jouw doel voldoet.
Kun je een specifieke nauwkeurigheid garanderen?
Niemand kan eerlijk beloven nauwkeurigheid voordat we de data gezien hebben. Ik deel vroeg een baseline, leg uit wat de nauwkeurigheid beperkt en verbeter het model in jouw revisies.
Kan ik het model zelf draaien?
Ja. Je krijgt het getrainde model, de code en een voorspellingsscript. Standaard voegt een FastAPI-endpoint toe, en Premium voegt Docker toe.
Doe je ook beeld- of computer vision-projecten?
Niet in deze dienst. Ik richt me op tabulaire data uit spreadsheets en databases.
Blijven mijn gegevens privé?
Jouw data wordt uitsluitend voor jouw project gebruikt en nooit gedeeld. Ik verwijder mijn kopieën na levering als je dat vraagt.