Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
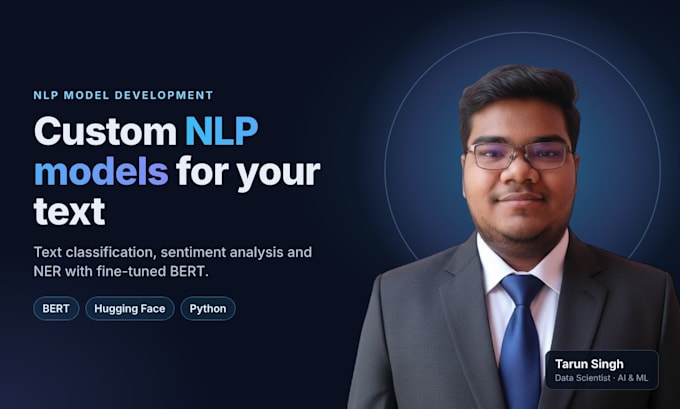
AI-ingenieur, LLM, RAG en NLP-ontwikkelaar
Nog een model nodig dat jouw tekst begrijpt: reviews, supporttickets, e-mails, reacties of documenten?
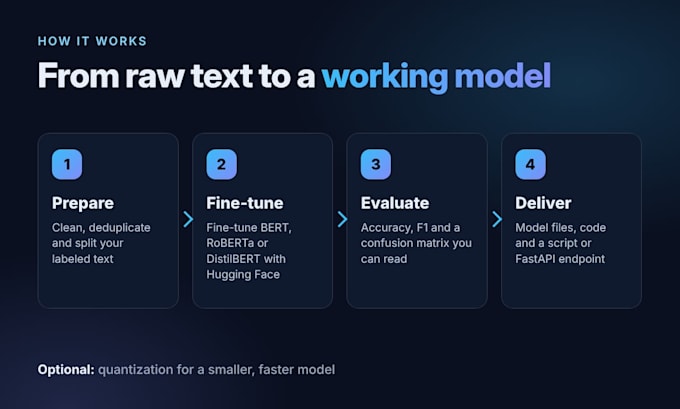
Ik bouw en stem NLP-modellen af met BERT, RoBERTa en DistilBERT die ruwe tekst omzetten in nauwkeurige voorspellingen.
Wat ik kan bouwen:
Wat je krijgt:
Waarom ik?
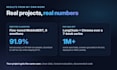
Ik ben een Data Scientist die dagelijks aan NLP en LLMs werkt. Ik heb MobileBERT afgesteld tot 91,9% nauwkeurigheid bij 6-klasse-emotieherkenning, daarna de grootte gehalveerd met quantisatie terwijl ik 91,1% behield. Op het werk bouw ik LangChain LLM-pijplijnen en FastAPI-services die in productie draaien.
Stuur me je data en doel voordat je besteld, dan raad ik het juiste pakket aan.
Programmeertaal:
Python
•
SQL
•
Colab
•
NoSQL
•
MLflow
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-notitieboek
•
tensorflow
•
Excel
•
MLflow
•
Colab
Automatische vertaling
Welke gegevens moet ik verstrekken?
Een CSV- of Excel-bestand met jouw tekst en labels werkt het beste. Geen labels? Ik kan een labeling-plan voorstellen of zero-shot en LLM-gebaseerde methodes gebruiken om je op weg te helpen.
Welke modellen gebruik je?
BERT, RoBERTa, DistilBERT of MobileBERT, en open-source LLMs zoals Llama of Mistral via Hugging Face. Ik kies het kleinste model dat aan jouw nauwkeurigheids- en snelheidseisen voldoet.
Kun je een specifieke nauwkeurigheid garanderen?
Niemand kan eerlijk beloven dat de nauwkeurigheid meteen 100% is voordat we de data zien. Ik laat een baseline zien, leg de resultaten duidelijk uit en verbeter het model binnen jouw pakketrevisies.
Kan ik het model zelf draaien?
Ja. Je krijgt de getrainde modelbestanden, de code en een eenvoudige inferentiescript. Standaard voegt een FastAPI-endpoint toe, en Premium voegt Docker en cloud-deployments toe.
Werk je met andere talen dan Engels?
Ja. Ik gebruik meertalige modellen zoals XLM-RoBERTa en mBERT, inclusief Hindi en andere Indiase talen.
Blijven mijn gegevens privé?
Jouw data wordt uitsluitend voor jouw project gebruikt en nooit gedeeld. Ik verwijder mijn kopieën na levering als je dat vraagt.