Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD


Automatische vertaling
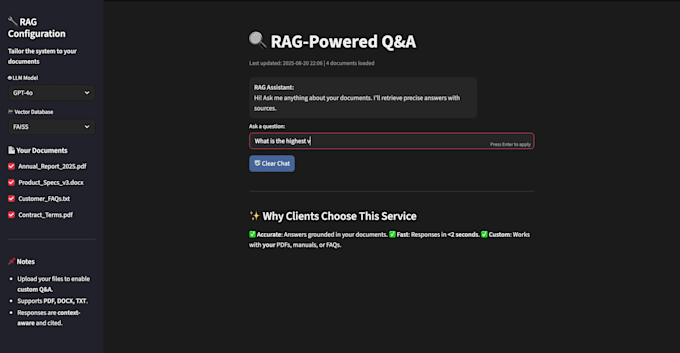
Wil je je AI-toepassingen een boost geven met Retrieval-Augmented Generation (RAG)? Je bent op de juiste plek!
Ik ontwerp en implementeer een production-ready RAG pipeline die de kracht van Large Language Models (LLMs) combineert met slimme retrieval-systemen, zodat jouw AI accurate, contextbewuste en actuele antwoorden kan geven.
Wat ik aanbied:
End-to-End RAG pipeline ontwikkeling (retriever + generator)
Integratie met vector databases (Pinecone, Weaviate, FAISS, Milvus, etc.)
Documentinvoer & chunking met embeddings
API-klaar deployment (FastAPI/Flask)
Fijn afstemmen voor domeinspecifieke toepassingen
Explainable AI integratie voor transparantie
Optimalisatie voor schaalbaarheid & latency
Gebruiksscenario's:
Waarom voor mij kiezen?
Als een expert ML/AI engineer en Python ontwikkelaar heb ik echte RAG-oplossingen gebouwd die schaalbaar, flexibel en op maat gemaakt zijn voor zakelijke behoeften. Ik zorg voor schone, gedocumenteerde en production-ready code zodat je met vertrouwen kunt opschalen.
Hi, I'm Tauseef Ahmed, an AI ML engineer with 7 years of experience
Talen
Automatische vertaling
Automatische vertaling
Wat is een RAG-oplossing?
Een RAG (Retrieval-Augmented Generation) oplossing combineert een retriever (relevante kennis ophalen uit een database) met een generator (LLM zoals GPT) om accurate, contextbewuste en betrouwbare antwoorden te leveren.
Waarom heb ik RAG nodig in plaats van een normaal LLM?
Standaard LLMs kunnen hallucineren of verouderde antwoorden geven. Met RAG heeft je AI toegang tot real-time, domeinspecifieke kennis, wat zorgt voor correctheid, betrouwbaarheid en minder hallucinaties.
Welke vector databases ondersteund je?
Ik ondersteun Pinecone, Weaviate, FAISS, Milvus, Chroma en ElasticSearch. Als je een andere in gedachten hebt, kan ik die ook integreren.
Kan je de oplossing naar productie deployen?
Ja! Ik kan je RAG pipeline als API (FastAPI/Flask) deployen, integreren in chatbots of webapps, en klaarzetten voor schaalbaarheid in cloudomgevingen (AWS, GCP, Azure, etc.) (Specifiek plan alleen).
Heb ik mijn eigen LLM nodig of kunnen we OpenAI/anderen gebruiken?
Beide zijn mogelijk! Ik kan OpenAI, Anthropic, Cohere, HuggingFace modellen of je eigen fijn afgestelde LLM integreren, afhankelijk van je behoeften.
Kun je het domeinspecifiek maken (juridisch, medisch, financieel, etc.)?
Absoluut ✅. Ik kan embeddings, retrieval-logica en pipeline setup finetunen voor domeinspecifieke toepassingen, zodat je RAG-oplossing perfect past bij jouw branche.
Hoe waarborgt u de privacy en veiligheid van gegevens?
Ik gebruik veilige pipelines, private vector stores en toegangsgestuurde APIs om je gevoelige data te beschermen. Deployment kan op je eigen servers of cloudaccounts voor volledige controle.
Wat heb ik nodig om te beginnen?
Deel gewoon je wensen, beschikbare data (documenten, kennisbank, etc.) en je voorkeurs-technologie stack. Ik begeleid je door de rest!