Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD

Level 2
Automatische vertaling
Het verzenden van gevoelige bedrijfsgegevens naar openbare AI-servers is een serieus privacyrisico en de maandelijkse API-kosten lopen snel op.
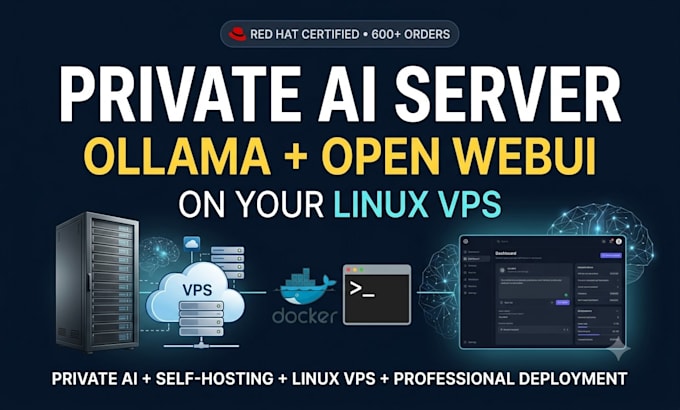
Ik implementeer een volledig private, zelfgehoste AI chatbot op jouw Linux VPS met behulp van Ollama + Open WebUI, waardoor jouw team een veilige ChatGPT-achtige ervaring krijgt zonder terugkerende kosten.
Als een door Red Hat gecertificeerde engineer (RHCSA/RHCE, 14+ jaar, 600+ opdrachten) installeer ik het niet alleen; ik beveilig het zodat het niet online blootgesteld blijft.
Wat ik doe:
Docker, Ollama en Open WebUI installeren & configureren
Open-source LLMs implementeren (Llama 3, Mistral, DeepSeek, Qwen)
Nginx reverse proxy met SSL (HTTPS) instellen
Realtime token streaming activeren
Beheerpanel, gebruikersauthenticatie & multi-user toegang configureren
Firewall & basis server hardening inbegrepen
RAG instellen voor PDF/document query’s (Standaard & Premium)
Volledige setup documentatie
Waarom deze gig:
100% privé jouw data verlaat nooit jouw server
Geen API-kosten, geen tokenlimieten
Productieklaar, stabiel & veilig
Werkt op elke VPS: DigitalOcean, Hetzner, Vultr, Contabo, AWS, Linode. GPU en CPU-only ondersteund.
Let op: modelprestaties hangen af van jouw CPU/RAM/GPU.
Neem contact met mij op voordat je bestelt om je specificaties en doelen te bevestigen.
Linux Server Security Expert cPanel WHM Cloudflare Docker RHCSA RHCE
Level 2
Talen
Automatische vertaling
Automatische vertaling
Wat zijn de minimale serververeisten?
Voor lichte modellen zoals Llama 3.2 (3B) of Mistral heb je minimaal 4GB RAM en 2 CPU-kernen nodig. Voor grotere modellen (8B+), adviseer ik 8GB–16GB RAM. Weet je niet zeker over je specs? Deel ze vóór het bestellen en ik adviseer het beste model voor jouw hardware.
Is mijn data echt privé?
100% ja. Dit draait volledig op jouw eigen server — jouw chats, documenten en data verlaten nooit jouw machine. Er zijn geen API-aanroepen naar OpenAI of derden. Volledige privacy by design.
Heb ik een OpenAI API-sleutel of abonnement nodig?
Nee. Deze setup gebruikt gratis, open-source modellen via Ollama. Zodra het is geïnstalleerd, kun je de AI onbeperkt gebruiken — geen kosten per token, geen maandelijkse kosten, nooit API-sleutels.
Kan dit zonder GPU draaien?
Absoluut. Ik optimaliseer modellen voor CPU-only VPS-omgevingen met 4-bit quantisatie. Een GPU geeft snellere reacties, maar moderne CPU's kunnen dagelijkse taken verrassend goed aan.
Kan mijn team dit samen gebruiken?
Ja. Standaard en Premium pakketten bevatten multi-user authenticatie. Je krijgt een beheersconsole om accounts aan te maken, toegang te beheren en te bepalen wie de platform gebruikt.
Wat is RAG en heb ik het nodig?
RAG (Retrieval-Augmented Generation) laat je AI vragen beantwoorden uit je eigen privé documenten — PDFs, Word-bestanden, tekstbestanden. Upload een document en vraag de AI alles erover. Inbegrepen bij Standaard en Premium pakketten.
Welke Linux-distributie raad je aan?
Ubuntu 22.04 LTS of 24.04 LTS wordt sterk aanbevolen voor de beste stabiliteit en compatibiliteit. Ik kan ook werken met Debian, CentOS of AlmaLinux indien nodig.
Wat als mijn VPS niet genoeg RAM heeft voor het model dat ik wil?
Ik controleer je server-specificaties nadat je hebt besteld. Als je hardware je favoriete model niet aankan, adviseer ik het beste alternatief en vraag ik je bevestiging voordat ik verder ga — geen verrassingen.
Blijft de AI-server draaien nadat ik klaar ben?
Ja. Alles is geconfigureerd als een persistent Docker-service die automatisch opstart bij reboot. Je AI-server draait 24/7 zonder handmatige ingrepen.
