Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Azure Databricks- en PySpark Data Engineer
Nodig je een betrouwbare pijplijn op Azure Databricks, of een die steeds mislukt? Ik ben een Azure Data Engineer met ongeveer 4 jaar ervaring in het bouwen van productie-lakehouse-pijplijnen op Databricks, PySpark, Azure Data Factory, Delta Lake en Unity Catalog.
Wat ik doe:
Hoe we werken: deel jouw notebook of code en voorbeelddata (dummy data is prima), of geef mij least-privilege workspace-toegang via jouw eigen admin. Stuur nooit wachtwoorden of sleutels.
Ik gebruik AI-ondersteunde tooling, en elke levering wordt door mij getest en gedocumenteerd.
Stuur me voor het bestellen een bericht zodat ik de scope en planning kan bevestigen.
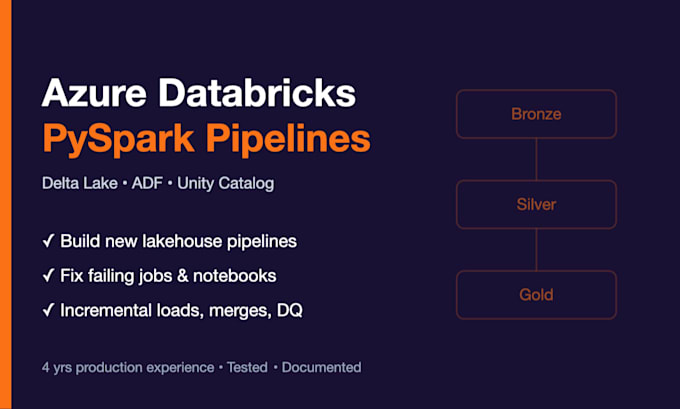

Tools & platforms:
Azure Data Factory
Automatische vertaling
Heb je mijn Azure- of Databricks-wachtwoord nodig?
Nee. Deel code en voorbeelddata, of laat jouw admin mij een least-privilege-gebruiker in jouw workspace geven. Wachtwoorden of sleutels neem ik nooit mee.
Kun je ook op AWS of GCP werken in plaats van Azure?
Ja, voor Databricks en PySpark op elke cloud. Mijn diepste ervaring ligt bij Azure, dus stuur alsjeblieft eerst een bericht met jouw setup.
