Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Full Stack Web, DevOps en AI-automatisering, The Burujan
Fraude-verliezen doen pijn, maar ook valse alarmen die goede klanten blokkeren. Ik bouw een fraudedetectiemodel met machine learning in Python dat meer fraudevangt en minder echte klanten markeert.
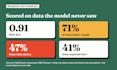
Ik ben Huzaifa van The Burujan, een NOC-engineer die data science-projecten bouwt. Mijn fraude-detectie-project voor creditcard gebruikt 590.540 echte kaarttransacties waarbij slechts 3,5% fraude is. Op een latere testset die het model nog niet gezien had, bereikte het 0,91 ROC AUC, ving 71% van de fraudebedragen op en verminderde het valse alarm met 47% vergeleken met een standaard model bij dezelfde fraude-opname.
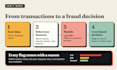
Wat je krijgt: data cleaning, gedragskenmerken zoals bestedingsgeschiedenis en snelheid, behandeling van klasse-imbalances, getunede LightGBM- en XGBoost-modellen, een beslissingsdrempel gebaseerd op jouw kosten van fraude versus een valse melding, SHAP-uitleggen zodat analisten zien waarom elke transactie werd gemarkeerd, en een rapport met een Jupyter-notebook. Premium voegt een scoring API, bewakingsplan en reconstructiehandleiding toe.
Ik split data op tijd, niet willekeurig, zodat de resultaten eerlijk zijn. Geen enkel model kan zero fraude garanderen, en de resultaten hangen af van jouw data. Stuur me een bericht voor het plaatsen van een bestelling met een korte beschrijving van jouw data en ik vertel je of het past.
Programmeertaal:
Python
•
SQL
Frameworks:
Scikit-learn
Tools:
Jupyter-notitieboek
•
Colab
Automatische vertaling
Welke gegevens moet ik verstrekken?
Een tabel met eerdere transacties met een fraude-label (0 of 1), als CSV of database-export. Enkele maanden historie met tijdstempels en bedragen werkt het beste. Kaart-, apparaat- en e-mailvelden helpen, maar zijn optioneel.
Levert het model echt minder valse alarmen op?
Bij mijn project verminderde het valse alarm met 47% ten opzichte van een standaard model bij dezelfde fraude-dollaropname, op een latere testset. De resultaten hangen af van jouw data, dus rapporteer ik dezelfde maatstaven op jouw eigen hold-out data.
Kun je het als een API implementeren?
Ja. Het Premium-pakket bevat een scoring API met overdrachtsnotities. Ik werk in Python met LightGBM, XGBoost en scikit-learn, en kan jouw stack inpassen als je laat weten wat je gebruikt.


