Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Senior Python ontwikkelaar, Android reverse engineering, AI agents en RAG
Ik maak Python web scrapers die blijven werken op sites die bots blokkeren. Voor JavaScript-rijke of beveiligde sites gebruik ik Playwright om een echte browser te besturen. Voor eenvoudige pagina's gebruik ik snellere tools zoals requests en curl_cffi. Zo krijg je betrouwbare data, geen script dat volgende week kapot is.
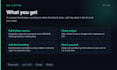
Ik heb scrapers geleverd voor vacaturebanken, e-commerce productcatalogi en grote archieven van kranten, met output in CSV, JSON, Excel of database, waarbij elk veld wordt gecontroleerd tegen de live pagina. Ik regel paginering, inloggen, dynamische content en anti-bot systemen zoals Cloudflare, Turnstile en PerimeterX met proxy-rotatie en retry-logica.
Je krijgt de volledige source code, documentatie en instructies voor deployment of scheduling, zodat je het zelf kunt herhalen. Ik heb ook een tool ontwikkeld die een site profileert op 28 factoren om de juiste scraping-methode te kiezen, zodat ik de aanpak afstem op jouw target in plaats van één tool te forceren.
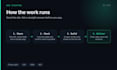
Vertel me de site en de velden die je nodig hebt voordat je bestelt, dan vertel ik je wat mogelijk is en wat het kost.
Technologie:
Python
•
Scrapy
•
Beautiful Soup
•
Toneelschrijver
Techniek:
Geautomatiseerd
Automatische vertaling
Waar gebruik je scrapers voor?
Meestal Python. Playwright voor JavaScript-rijke of beveiligde sites, requests of curl_cffi met BeautifulSoup voor snelle statische scraping, Scrapy voor grote crawls. Ik kies op basis van het target, niet een vaste stack.
Hoe snel krijg ik het?
Een enkele statische site duurt meestal 2 tot 3 dagen. Dynamische sites met anti-bot handling duren 4 tot 7 dagen, afhankelijk van pagina's en velden. Je krijgt een vaste schatting nadat ik de site heb gezien, voordat je bestelt.
Krijg ik de broncode?
Ja. Elke opdracht bevat volledige Python source, een README en commentaar. Je kunt het uitvoeren, aanpassen of aan je eigen dev geven. Niets is vergrendeld of geobfusceerd.
Kun je omgaan met sites met sterke anti-bot bescherming?
Meestal wel. Ik werk met Cloudflare, Turnstile en PerimeterX met proxy-rotatie, echte browser-automatisering en retry-logica. Sommige targets zijn moeilijker dan andere, dus ik check die eerst en vertel je eerlijk de haalbaarheid voordat je betaalt.
Wat als de data met JavaScript wordt geladen?
Daar is Playwright voor. Het bestuurt een echte browser, wacht tot de content is gerenderd, regelt inloggen, klikken en oneindig scrollen, en haalt vervolgens de weergegeven data op.
Welke formaten leveren jullie?
CSV, JSON, Excel of direct in een database. Bij een recente catalogus-scrape werd elk veld gecontroleerd tegen de live pagina zodat de kolommen kloppen en niets wordt beschadigd. Vertel me de vorm die je nodig hebt.
Kan het op een schema draaien, niet alleen één keer?
Ja. Dagelijks of hourly, gededupliceerd tegen wat al is gehaald, nieuwe rijen in een bestand, sheet, database of API. Instructies inbegrepen zodat je het zelf op je eigen machine of server kunt draaien.
Wat als de scraper data mist of aanpassingen nodig heeft?
Revisies zijn inbegrepen en ik test het tegen de live site voor levering. Als de layout later verandert, vertel ik je wat een fix kost. Kleine tweaks na levering zijn meestal snel gedaan.
Hoe beginnen we?
Stuur de site URL en de exacte velden die je wilt, plus een voorbeeldpagina als je die hebt. Ik bevestig dat het scrapable is, adviseer een pakket en geef je een tijdlijn. Daarna bestel je.


