Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Data-analist en data scientist
Ik bouw classificatie-, regressie- en clusteringmodellen voor tabulaire data in Python. R is op afspraak beschikbaar.
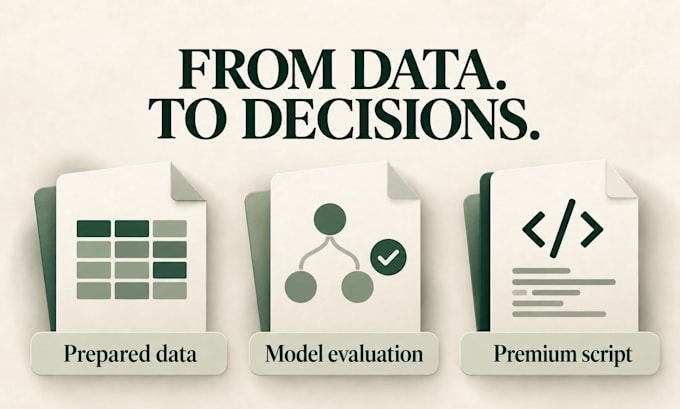
Inbegrepen: verkennende data-analyse (EDA), afgesproken schoonmaak en preprocessing, modeltraining, evaluatie en optimalisatie. Je ontvangt commentaarcode, documentatie en duidelijke uitleg van resultaten en beperkingen.
Elk pakket dekt 1 tabel en 1 predictiedoel of clusteringvraag:
Invoercolommen worden geteld vóór codering; de doeltabelkolom is optioneel waar van toepassing. Je data hoeft niet modelklaar te zijn.
Bestanden: CSV, Excel of SPSS (.sav).
Stuur me een bericht voordat je bestelt met jouw doel, bestandsformaat, afmetingen en een geanonimiseerd sample. We bevestigen eerst haalbaarheid en de reikwijdte van de preprocessing. Tafel- en datafusie, handmatig dat hersamenstellen en database-extractie vereisen een aparte offerte.
Portfolio-voorbeeld: LearnerCue
https://tonywillert.github.io/Portfolio/#learnercue


Programmeertaal:
Python
•
R
•
SQL
•
NoSQL
Frameworks:
Scikit-learn
•
keras
•
PyTorch
•
Panda
Tools:
Jupyter-notitieboek
•
tensorflow
•
Excel
•
RStudio
Automatische vertaling
Welke machine learning taken bied je aan?
Ik bouw classificatie-, regressie- en clusteringmodellen voor gestructureerde, tabulaire data. Typische doelen zijn het voorspellen van een uitkomst, het schatten van een waarde of het identificeren van groepen. Ieder order bevat één afgesproken voorspellingdoel of clusteringvraag.
Moet mijn data eerst opgeschoond worden?
Nee. Je data moet een gestructureerde tabel zijn, maar het hoeft niet modelklaar te zijn. EDA en afgesproken preprocessing zijn opgenomen binnen de pakketgrenzen, zoals schoonmaak, het omgaan met ontbrekende waarden, coderen van categorieën en schalen van kenmerken.
Hoe worden de limieten van het pakket geteld?
Elk pakket dekt één tabel. Beperkingen: Basic 2.000 rijen/10 invoerkolommen; Standard 10.000/20; Premium 30.000/30. Kopteksten tellen niet mee als rijen. Invoerkolommen worden geteld vóór codering; een doelkolom is additioneel indien nodig.
Wat krijg ik bij elk pakket?
Alle pakketten bevatten gecommentarieerde code, evaluatieresultaten en documentatie. Basic dekt één algoritme; Standard en Premium tot drie. Premium voegt een herbruikbaar voorspellingsscript en een handleiding toe voor data met dezelfde structuur. Herhaalde fits tijdens afstemming tellen als hetzelfde algoritme.
Welke bestandsformaten en talen support je?
Ik accepteer CSV, Excel (.xlsx) en SPSS (.sav). Python is standaard; R is op overeenkomst beschikbaar. Een data-woordenboek is handig. Database-extractie, tabellen samenvoegen en handmatige reconstructie vereisen een aparte scope en offerte voorafgaand aan de bestelling.
Kun je een specifieke nauwkeurigheid garanderen?
Geen specifieke score of bedrijfsresultaat wordt gegarandeerd. Prestaties hangen af van data kwaliteit, beschikbare informatie en de taak. We beoordelen haalbaarheid voorafgaand aan de bestelling. Ik gebruik passende validatie en leg de gemeten prestaties en beperkingen uit.
Wat houdt een revisie in?
Een revisie is één geconsolideerde ronde van aanpassingen binnen de afgesproken scope. Basic en Standard bevatten één; Premium bevat twee. Nieuwe analyses, datasets, doelen of leverables vereisen een aparte offerte. Fouten bij de uitvoering van het afgesproken werk worden gecorrigeerd.
Zijn deployment en doorlopend onderhoud inbegrepen?
De pakketten behandelen modelontwikkeling en overdracht. Cloud-deployment, API-integratie, geplande runs, voortdurende monitoring en onderhoud vallen buiten de scope. Het fijn afstemmen van voorgetrainde modellen is ook apart. Bespreek deze vereisten voorordering.
Wat moet ik sturen voordat ik bestel?
Stuur jouw doel, bestandsformaat, rijen- en kolomtellingen, kolomomschrijvingen en een klein synthetisch of volledig geanonimiseerd voorbeeld dat je mag delen. We bevestigen haalbaarheid, voorbereidingsbehoeften, geschikte bestanden en de overdrachtmethode voordat het werk begint.