Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
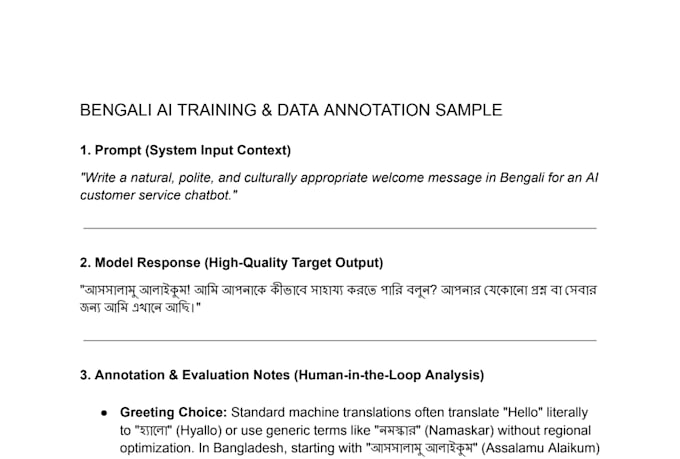
Ben je op zoek naar een native Bengali spreker om datasets te finetunen, annoteren of evalueren voor jouw LLM en AI-modellen? Je bent op de juiste plek!
AI-modellen zijn slechts zo goed als de data waarop ze getraind worden. Slechte vertalingen, onnatuurlijke zinsbouw en culturele fouten kunnen de prestaties van je model verpesten. Als native Bengali spreker met een diep begrip van linguïstische nuances bied ik hoogwaardige datadiensten om jouw AI vloeiend, natuurlijk en cultureel accuraat te maken.
Wat ik voor jouw AI-project kan doen:
Waarom voor mij kiezen?


Techniek:
Handleiding
Type tagging:
Tekst
•
Afbeelding
•
Audio
Automatische vertaling
Kun je werken met specifieke data annotatie platforms zoals Labelbox, Scale AI of aangepaste UI's?
Ja, absoluut. Ik ben zeer tech-savvy en kan me gemakkelijk aanpassen aan elk derde-platform of eigen hulpmiddel dat jouw bedrijf gebruikt. Je kunt me eenvoudig toevoegen aan je workspace via e-mail of de projectgegevens delen, en ik volg strikt jouw richtlijnen.
Hoe garandeer je de kwaliteit en nauwkeurigheid van de Bengali training data?
Als native Bengali spreker controleer ik elk datapunten handmatig. Ik focus sterk op contextuele nauwkeurigheid, natuurlijke grammatica en juiste sentimentafstemming. Ik gebruik nooit geautomatiseerde tools, bots of machine-vertalers voor mijn werk, zodat ik hoge kwaliteit data voor jouw LLM garandeer.
Onderteken je Non-Disclosure Agreements (NDA's) voor gevoelige of eigendomsdatasets?
Ja, ik begrijp dat trainingsdatasets waardevolle intellectuele eigendom zijn. Ik behandel alle klantgegevens met de hoogste vertrouwelijkheid. Als jouw team een NDA vereist voordat je data deelt, ben ik volledig bereid om deze te bekijken en te ondertekenen.
Kun je grote datasets of lange termijn contracten aan?
Ja! Hoewel mijn pakketten specifieke aantallen dekken, kan ik veel grotere volumes aan via aangepaste mijlpalen. Voor doorlopende projecten of enorme datasets stuur me gerust een bericht met jouw wensen, richtlijnen en planning, zodat ik een op maat gemaakt aanbod kan maken.