Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Business Intelligence engineer
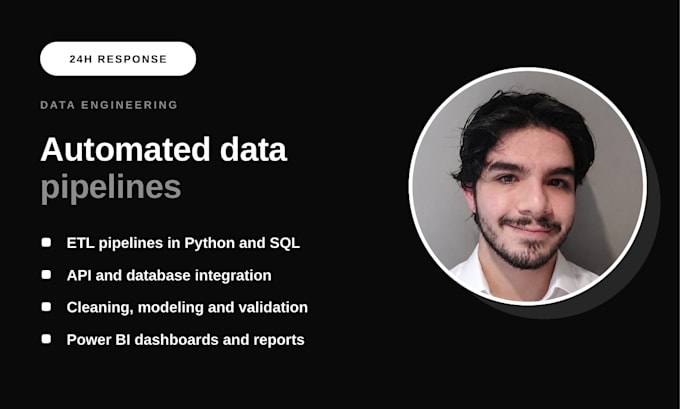
Organisaties kunnen moeite hebben met rommelige data die verspreid is over verschillende systemen. In mijn dagelijkse werk ben ik verantwoordelijk voor het overbruggen van die kloof, het ontwerpen van de analytische laag van het bedrijf en het volledig beheren ervan. Ik hoop kleinere bedrijven of zelfstandigen te helpen hetzelfde te bereiken.
Wat ik aanbied:
Stack: Python, geavanceerd SQL, PySpark, dbt, Databricks, Microsoft Fabric, AWS, Power BI.
Vertel me wat je probeert te bereiken en we kunnen vanaf daar verder werken!
Technologie:
Python
•
SQL
Automatische vertaling
Wat heb je van mij nodig om te beginnen?
Toegang tot of voorbeeldbestanden van je bronnen, en een beschrijving van wat je aan het einde wilt zien. Als het een API is, inloggegevens of documentatie. Ik bevestig de scope voordat je bestelt.
Gaat dit automatisch draaien nadat je hebt geleverd?
Bij Standard en Premium wel — je krijgt een geplande refresh script en setup documentatie. Basic is een eenmalige schone extractie.
Krijg ik de broncode?
Inbegrepen bij Standard en Premium. Als extra beschikbaar bij Basic.
Mijn data is rommelig en inconsistent over systemen. Is dat een probleem?
Nee, dat is de normale situatie. Cross-system entity resolution waar identifiers niet matchen, is een routine onderdeel van het werk.
