Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr

Automatische vertaling
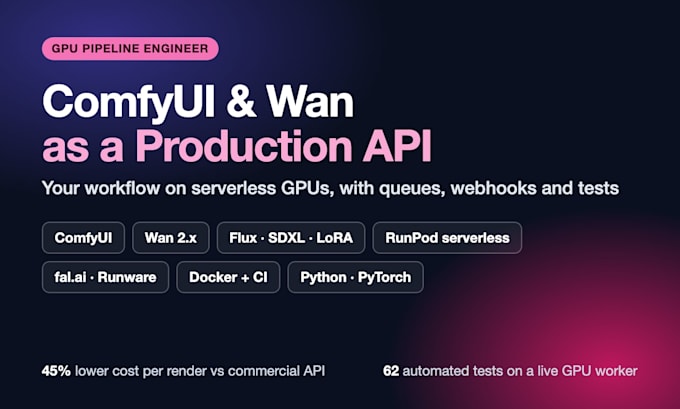
Heb je een ComfyUI-workflow die op jouw desktop werkt maar die als betrouwbare API voor jouw app, bureau of SaaS moet draaien?
Ik zet ComfyUI, Wan, Flux en Stable Diffusion-workflows om in production services: serverless GPU-werkers op RunPod, of hostgebaseerde inference via fal.ai en Runware wanneer jij geen infrastructuur wilt beheren.
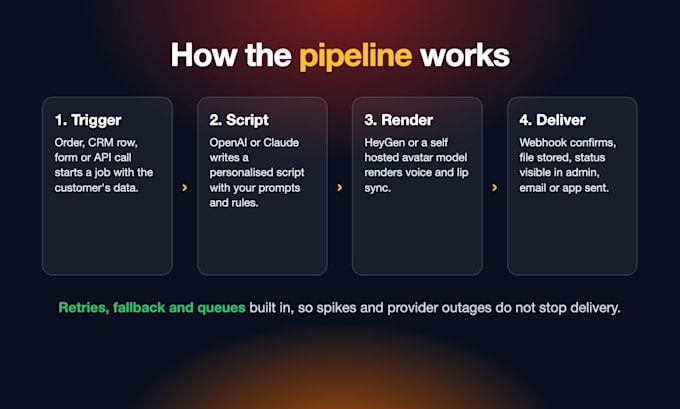
Wat ik bouw:
Bewijs: een zelf-gehoste avatar-rendering-worker die ik bouwde heeft 62 automatische tests en kostte per rendering ongeveer 45% minder dan de commerciële API, met automatische fallback.
Stack: Python, Docker, RunPod, ComfyUI, PyTorch, Node.js, Supabase.
Stuur eerst een bericht met jouw workflow of model en ik reageer met een plan en een vaste prijs.
AI Developer for AI Agents, n8n Automation, Claude Code and GenAI Video
Talen
Automatische vertaling
Automatische vertaling
Kun je het voor mij hosten of heb ik mijn eigen GPU-account nodig?
Het draait in jouw eigen RunPod-, fal.ai- of Runware-account, dus jij bezit de sleutel, data en facturering. Ik zet alles op, lever de Docker-afbeelding en het eindpunt aan en laat jouw team zien hoe modellen te updaten.
Ondersteun je modellen en workflows?
ComfyUI-grafieken met elke aangepaste node, Wan 2.x-tekst naar video, Flux, SDXL, LoRA, ControlNet, upscalers, achtergrondverwijdering en pratende avatar-modellen. Als het draait in ComfyUI of op Hugging Face, kan ik het leveren.
Hoe houd je GPU-kosten laag?
Serverless workers die naar nul schalen, afgestemde koude starts met ingebakken modellen, batching en caching, spot GPUs waar veilig, en een fallback naar een hosted provider zoals fal.ai zodat je nooit een render verliest. Je ziet de kosten per rendering in de logs.