Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Automatische vertaling
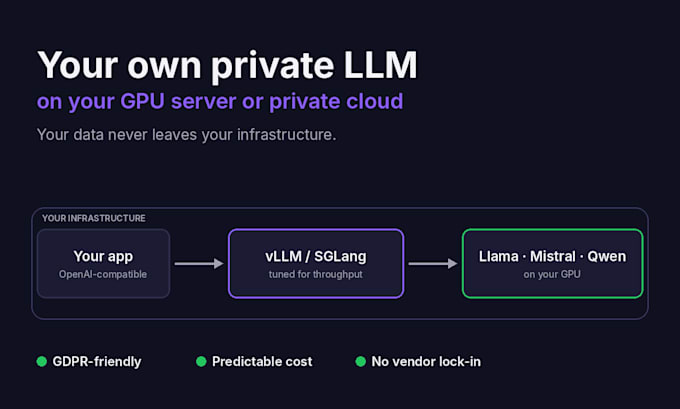
Wil je AI van ChatGPT-niveau zonder jouw data naar OpenAI te sturen? Ik implementeer een opensource LLM op jouw eigen GPU-server of privécloud, zodat prompts en documenten nooit jouw infrastructuur verlaten.
Ik ben een AI-engineer die een soevereine AI-variant in productie heeft gebouwd en gerund voor een Nederlandse hostingprovider met meer dan 1,4 miljoen abonnementen. Dit is echte inference-engineering, geen one-click Ollama-installatie.
Wat ik doe:
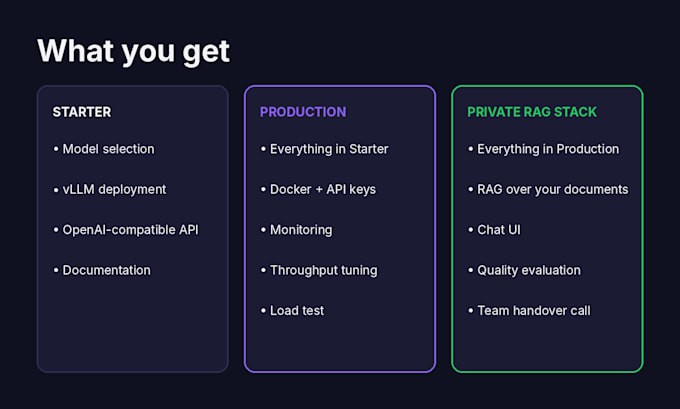
Kies het juiste model voor jouw taak en hardware (Llama, Mistral, Qwen, DeepSeek, Gemma)
Implementeer het met vLLM of SGLang achter een OpenAI-compatibele API, zodat jouw bestaande code gewoon werkt
Optimaliseer doorvoer, latency en GPU-geheugen (quantisatie, KV-cache, batching)
Voeg Docker, API-sleutels, monitoring en load testing toe voor real traffic
Optioneel: RAG over jouw eigen documenten met een chat UI
Goede match als je:
privacy-, GDPR- of compliance-eisen hebt
Te veel betaalt voor API-tokens en voorspelbare kosten wilt
Al GPUs hebt (on-prem, RunPod, Lambda, AWS, Hetzner) of hulp nodig hebt bij het kiezen ervan
Stuur me alsjeblieft een bericht voordat je bestelt met jouw use case en hardware, zodat ik het juiste pakket kan bevestigen.
Senior AIML Engineer
Talen
Automatische vertaling
Automatische vertaling
Heb ik mijn eigen GPU nodig?
Je hebt toegang nodig tot een GPU-server: on-prem of huur bij aanbieders zoals RunPod, Lambda, AWS of Hetzner. Als je er nog geen hebt, raad ik voor jouw model en budget de juiste GPU en provider aan voordat je bestelt.
Gaat het werken met mijn bestaande OpenAI-code?
Ja. De deployment biedt een OpenAI-compatibele API aan, dus in de meeste gevallen hoef je alleen de basis-URL en de modelnaam in je code aan te passen.
Welk model moet ik gebruiken?
Het hangt af van jouw taak, taal en GPU-geheugen. Ik raad een model aan (bijv. Llama, Mistral, Qwen, DeepSeek of Gemma) en een quantisatie-niveau zodat je de best mogelijke kwaliteit krijgt die jouw hardware snel kan draaien.
Hoe krijg je toegang tot mijn server?
Via een tijdelijk SSH-gebruiker of cloud-account met alleen de benodigde rechten. Je kunt mijn toegang verwijderen zodra het werk is opgeleverd.
Zal een self-hosted model net zo goed zijn als GPT-4?
Voor gerichte taken zoals document Q&A, samenvatten of classificeren zijn moderne open modellen vaak voldoende dichtbij. Voor breed redeneren kunnen ze achterblijven. Ik vertel je eerlijk wat je van jouw use case kunt verwachten voordat we beginnen.