Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
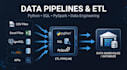
Heb je een betrouwbare ETL-pipeline of data engineering oplossing nodig voor je bedrijfsdata?
Ik bouw schone en schaalbare ETL-pipelines, datatransformaties en data engineering oplossingen op basis van Python/SQL.
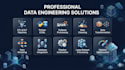
Waar ik mee kan helpen:
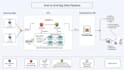
Mijn werkwijze:
Waarom met mij werken?
Neem contact met me op voordat je bestelt als je meerdere data bronnen hebt, grote datasets of complexe ETL-eisen.

Automatische vertaling
Kun je een ETL-pipeline bouwen van Excel of CSV?
Ja, ik kan Excel- of CSV-gegevens invoeren, schoonmaken, transformeren, valideren en laden in een geschikte database of bestemming.
Kun je werken met SQL databases?
Ja. Ik werk met PostgreSQL, MySQL, SQL Server en andere compatibele databases.
Kun je Python of PySpark gebruiken?
Ja. Ik kan Python of PySpark gebruiken, afhankelijk van de datavolume en pipeline-eisen.
Kun je ETL-pipelines plannen?
Ja, afhankelijk van het project, kan ik geplande of orchestrated data pipelines configureren.
Kun je werken met grote datasets?
Ja. Ik kan efficiënte verwerkingsworkflows ontwerpen voor grote datasets met SQL, Python en PySpark.


