Door categorieën bladeren
Nederlands
$
USD
Koppel je AI aan Fiverr
Bioinformatica- en RNA-seq-gegevensanalist
Wil je RNA-seq-gegevens omzetten in duidelijke, publicatieklare resultaten? Ik ben een bioinformatische analist met een MRes in Biomedical Research van Imperial College London en ik heb RNA-seq-pijplijnen opgebouwd voor academisch onderzoek.
Wat ik aanbied:
Kwaliteitscontrole en leesuitlijning (FastQC, STAR/HISAT2)
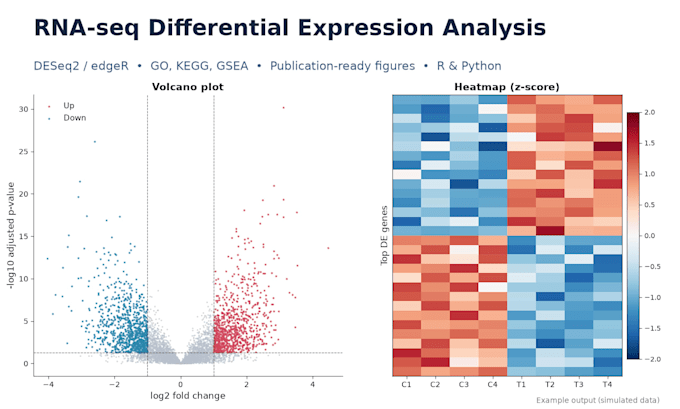
Differentieel expressie-analyses met DESeq2 of edgeR
Functionele verrijking: GO, KEGG en GSEA
Eenzelfige RNA-seq analyse
Publicatieklare figuren: volcaanplots, heatmaps, PCA, UMAP
Wat je krijgt:
Resultatentabellen (Excel/CSV) en hoge resolutie figuren
Schoon, becommentarieerde R- of Python-code zodat de analyse reproduceerbaar is
Een kort rapport waarin methoden en belangrijkste bevindingen worden uitgelegd (Standaard en Premium)
Stuur me vooraf een bericht met een korte omschrijving van je data (organisme, aantal monsters, bestandsformaat en de vergelijkingen die je nodig hebt), zodat ik het juiste pakket voor jou kan bevestigen.
Automatische vertaling
Welke gegevens moet ik je sturen?
Ruwe FASTQ-bestanden of een gen-tellingen-matrix, plus een sample sheet waarin de groepen/condities staan beschreven. Geef me het organisme en de vergelijkingen die je wilt. Publieke GEO/SRA-accensynummers werken ook.
Met welke organismen werk je?
Mens en muis het meest; maar elk organisme met een referentie-genoom en annotatie werkt. Stuur een bericht als je een niet-modelorganisme hebt en we bespreken het.
Krijg ik de code?
Ja. Standaard en Premium bevatten schone, becommentarieerde R- of Python-scripts zodat je elke stap kunt reproduceren en de methoden in je manuscript kunt beschrijven.
