Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Full Stack AI ontwikkelaar, NextJS en FastAPI specialist
Ik ontwerp, train en zet machine learning modellen in die echte problemen oplossen, niet alleen notebook-experimenten.
Recente modelwerkzaamheden:
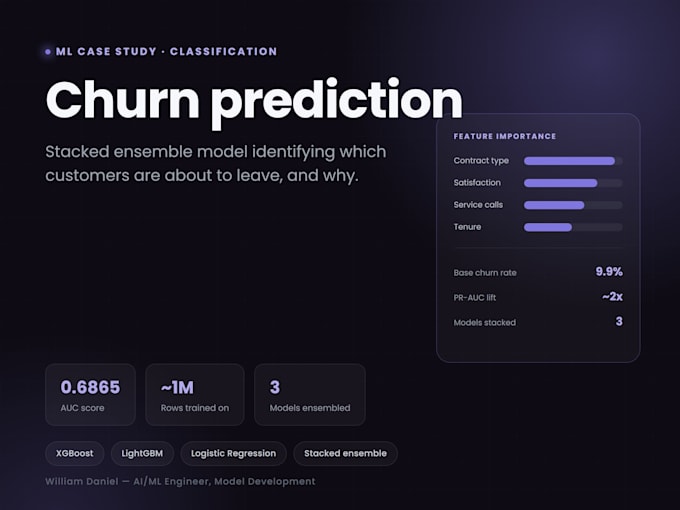
Customer churn prediction stacked ensemble (XGBoost + LightGBM + Logistic Regression), gevalideerd op een productie-achtige dataset van 1 miljoen rijen
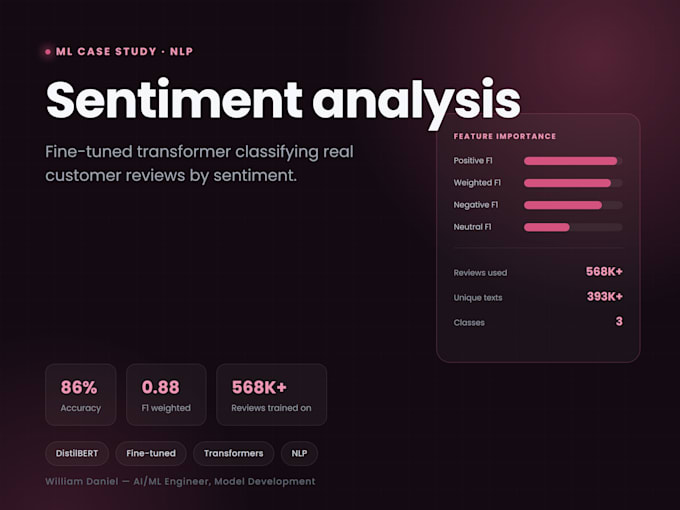
Customer sentiment analysis DistilBERT fijn afgesteld op meer dan 568K echte reviews, 86% nauwkeurigheid, F1 0.88
Multi-hazard weather risk model 7-koppen multi-task PyTorch netwerk getraind in 55 wereldwijde steden
Wat ik breng:
Strenge, iteratieve EDA, ik spring niet meteen naar modelleren
Modelvergelijking en tuning, niet alleen één standaard model
Explainability (SHAP / feature importance) zodat je begrijpt waarom het model voorspelt wat het voorspelt
Implementatie inclusief werkende API op jouw eigen hosting, niet alleen een opgeslagen modelbestand
Eerlijke rapportage, echte modellimieten worden gedocumenteerd, niet overdreven
Of je nu een dataset hebt die een echt model nodig heeft, of een bestaand model dat verbetering, explainability of deployment nodig heeft, ik regel het van begin tot eind.
Stuur me een bericht voordat je bestelt, zodat we je dataset en doel kunnen bevestigen. Een accurate scope betekent een beter resultaat voor jou.


Programmeertaal:
Python
•
SQL
•
Colab
•
MLflow
Automatische vertaling
Met wat voor soort ML-problemen kan ik je helpen?
Classificatie, regressie, clustering, tijdreeksvoorspelling, beeld- en audiobewerking, objectdetectie en NLP/sentiment taken. Stuur me je dataset en doel en ik bevestig of het past voordat je bestelt.
Moet ik de dataset aanleveren?
Ja, je levert de data (of wijst me op een openbare bron). Ik verzorg de schoonmaak, EDA, feature engineering, modellering en evaluatie vanaf daar.
Zal ik begrijpen waarom het model zijn voorspellingen doet?
Ja. Standaard en Premium omvatten explainability (SHAP of feature importance), zodat voorspellingen geen black box zijn.
Zullen de nauwkeurigheidscijfers eerlijk zijn, niet opgeblazen?
Altijd. Ik rapporteer echte evaluatiemetrics en bekende beperkingen. Een model dat je kunt vertrouwen is belangrijker dan eentje dat er alleen goed uitziet op papier.
Wat als mijn dataset klein of rommelig is?
Dat is normaal, de meeste echte datasets zijn dat ook. Ik doe eerst volledige EDA en schoonmaak, en geef vooraf aan of datakwaliteit de resultaten zal beperken, voordat je je budget besteedt.
Regel je deployment, of lever je alleen een modelbestand?
Standaard en Premium omvatten deployment als een werkende API/app op jouw eigen gratis hosting (geen terugkerende kosten via mij).