Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Clean Sourced Verified: Data entry, Excel, lead lijsten
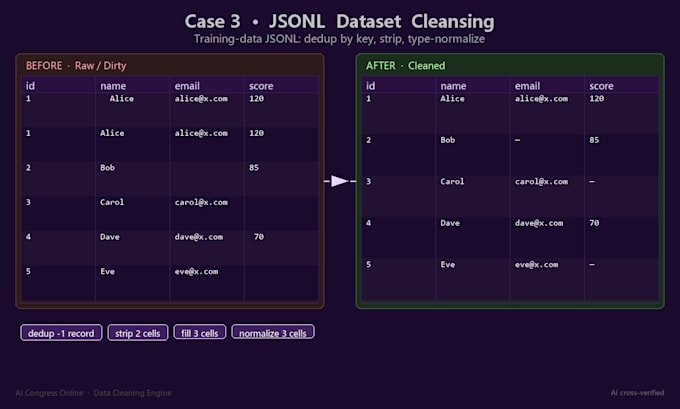
Ben je bezig met het bouwen van een LLM, RAG-systeem of fine-tuning project, maar is je training data een rommel? Dubbele rijen, inconsistente veldnamen, lege waarden, verkeerd gevormde JSONs—dit vertraagt niet alleen het trainen, maar vermindert ook stilletjes de kwaliteit van je modeloutput.
Ik maak en prepareer trainingsdatasets zodat ze direct in je pipeline kunnen worden gevoerd. Mijn pipeline verwerkt JSONL, CSV, XLSX, en zelfs rommelige exports van Notion, Excel of gescrapete bronnen. Elke schoonmaakactie wordt gelogd en je krijgt een rapport dat precies laat zien wat er is veranderd, niets wordt verborgen.
Dit maakt het anders:
Multi-model AI cross-verificatie op Standard/Premium twee AI-modellen bekijken de schoongemaakte data onafhankelijk, en discrepanties worden voor jou gemarkeerd
Schema behoud Ik schoon de data, ik raak je veldnamen of structuur nooit aan
Operatie audit trail elke dedup, elke normalisatie, elke verwijderde slechte rij wordt gedocumenteerd
Wat je krijgt:
1. Schoongemaakte dataset in het door jou gevraagde formaat
2. Een schoonmaakrapport dat laat zien wat er is gedaan
3. Gratis 1 ronde revisie
Stuur me eerst een voorbeeld van je data als je twijfelt, ik vertel je precies wat er moet worden schoongemaakt voordat je bestelt.
Automatische vertaling
Welke bestandsformaten accepteert u?
JSONL, CSV, XLSX en JSON. Als je iets anders hebt, stuur dan een voorbeeld en ik vertel je of het mogelijk is.
Verander je mijn data schema of veldnamen?
Nee. Ik maak de waarden schoon, niet de structuur. Jouw veldnamen, volgorde en schema blijven precies zoals ze zijn.
Wat betekent "AI cross-verification"?
Op Standard en Premium tiers bekijken twee onafhankelijke AI-modellen de schoongemaakte data en markeren ze eventuele afwijkingen. Je krijgt een rapport met wat ze eens waren en wat onzeker was.
Hoe snel kunt u leveren?
Basic (5K rijen) in 3 dagen, Standard (20K rijen) in 5 dagen, Premium (100K rijen) in 7 dagen. Spoedlevering mogelijk op aanvraag.
Wat als mijn data in een vreemde taal is?
De cleaning pipeline is taal-agnostisch. Het verwerkt datasets in Chinees, Japans, Engels of gemengde talen.