Door categorieën bladeren
Ontdekken
Fiverr Pro
Nederlands
$
USD
Automatische vertaling
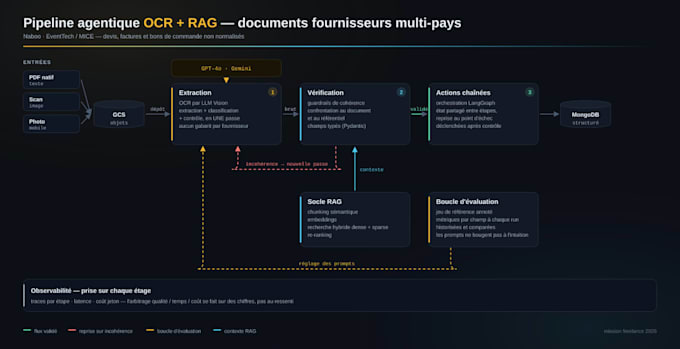
De meeste RAG-demo's falen in productie omdat de retrieval verkeerd is, niet het model. Ik zorg dat de retrieval goed is: semantisch chunking, embeddings, hybride dense+sparse search, re-ranking - en ik meet het met een evaluatieset, zodat elke verandering een nummer is, geen indruk.
Wat je krijgt: een chatbot die antwoordt op JOUW documenten, zijn bronnen citeert en "Ik weet het niet" zegt wanneer dat nodig is. Afgeleverd als een API (FastAPI) met een web chat, Dockerized, met traces en kosten per query.
Stack: Python, LangChain/LangGraph, Qdrant of Elasticsearch, OpenAI/Gemini/Mistral of open modellen op jouw infrastructuur.
Recent werk: productie RAG engine voor twee retailmerken (Mulliez groep), OCR+RAG pipeline voor een EventTech startup, document anti-fraud engine voor een bank.
Senior AI Engineer, 6+ jaar, gevestigd in Frankrijk. Ik leid teams van 2 tot 5 engineers.
Senior AI Engineer
Talen
Automatische vertaling
Automatische vertaling
Welke LLM gebruik je?
Jouw keuze: OpenAI, Gemini, Mistral, of een open model gehost bij jou voor vertrouwelijkheid. Ik adviseer er een op basis van jouw documenten en budget.
Mijn documenten zijn gescande PDFs. Is dat een probleem?
Nee. LLM-vision OCR is onderdeel van de pipeline: scans, foto's en niet-standaard lay-outs worden verwerkt.
Waar draait de chatbot?
In Docker op jouw server of jouw cloud (GCP, Azure, AWS). Niets blijft bij mij achter na levering.
Hoe weet ik dat het werkt?
Je krijgt een evaluatieset: jouw vragen, de verwachte antwoorden en een score per versie. Elke verandering wordt gemeten, niet geraden.